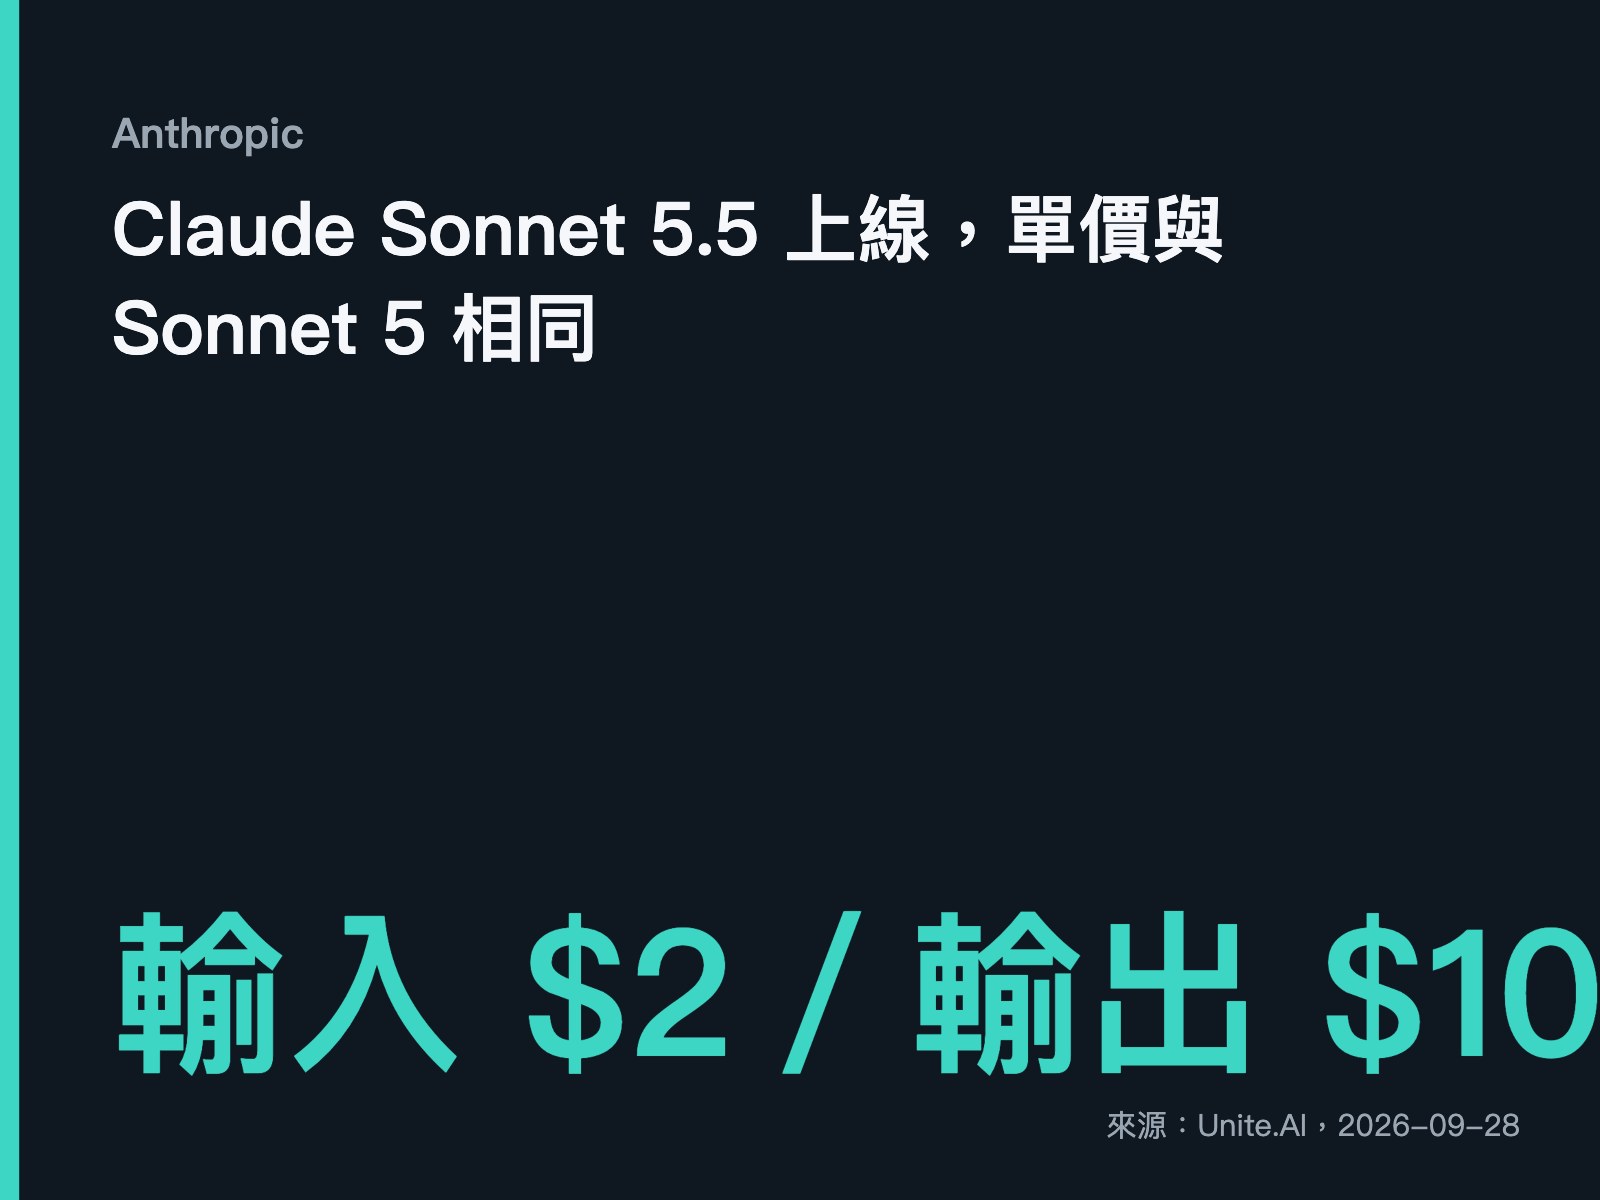
9 月 28 日,Anthropic 發布 Claude Sonnet 5.5,API 的模型名稱是 `claude-sonnet-5-5`。單價和 Sonnet 5 一樣:每百萬 token 輸入 2 美元、輸出 10 美元,快取讀取 0.2 美元,Batch API 五折。距離 9 月 22 日的 Opus 5.5 隔了六天。
官方的說法是輸出速度快 30% 以上、每個任務的成本最多低 30%。單價沒變,成本卻會下降,原因是完成同一件事需要的 token 變少。這個數字取決於你的工作內容,所以這篇要處理的是:哪些數字可以直接引用,哪些要自己量。
價格沒動,變的是每個任務用掉的 token
Sonnet 5.5 的定價表和 Sonnet 5 逐項相同。輸入 2 美元、輸出 10 美元,5 分鐘快取寫入 2.5 美元、1 小時快取寫入 4 美元,快取讀取 0.2 美元,Batch API 對輸入輸出各打五折。DataCamp 指出,這個價位大約是 Opus 5.5 的一半。
官方說「每任務成本最多低 30%」,前提寫在後半句:完成同樣的工作需要的 token 大幅減少。省下來的是模型少寫的字和少走的工具呼叫回合,每個 token 的價格沒有變。
早期測試者給的數字方向一致,但各家差很多。Box 回報速度是 2.4 倍、token 少 12%。Atlassian 說最多快 30%。Base44 的建置流程平均 3.6 次迭代完成,Opus 5 是 7.7 次。這些都是廠商轉述的合作夥伴數據,工作內容和計算方式各不相同,換算成你自己的成本沒有意義。
DataCamp 自己跑了一個實測:用 FiveThirtyEight 的資料集(173 個大學科系)做互動式 HTML 儀表板。Sonnet 5.5 做出能用的版本,還附了小樣本的資料品質警告,花費 0.56 美元。Sonnet 5 因為 Chart.js 函式庫匯入失敗,交出空白頁面,花費 0.57 美元。DataCamp 的結論是這個任務上兩者的每次執行成本幾乎一樣,差別在只有 Sonnet 5.5 交出了能用的東西。
這一組對照說明了一件事:官方的「最多低 30%」和單一實測的「幾乎一樣」並存,兩者都可能是對的,因為任務不同。
基準分數:追上 Opus 5.5 的範圍有多大
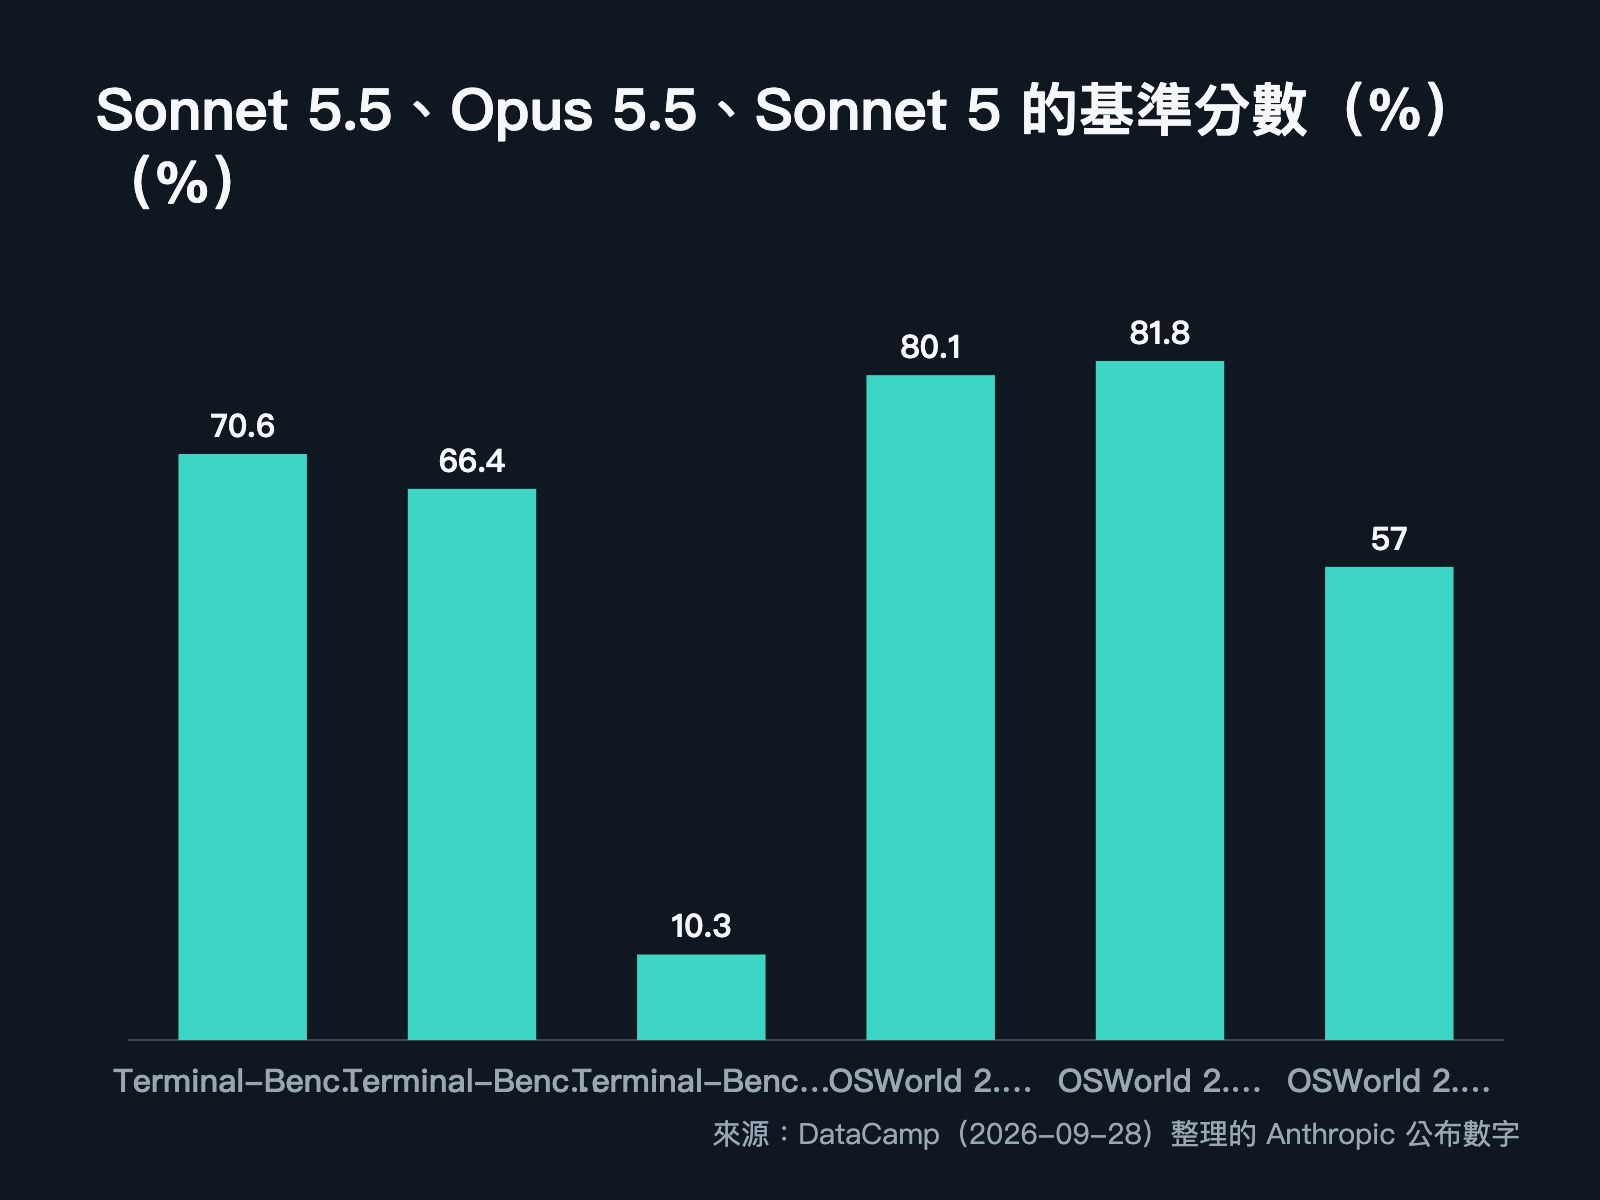
DataCamp 整理的數字如下(Sonnet 5.5/Sonnet 5/Opus 5.5):
在 Terminal-Bench 4.0,Sonnet 5.5 的 70.6% 高過 Opus 5.5 的 66.4%。GDPval-AA 的 1,844 與 Opus 5.5 的 1,846 只差 2 個 Elo,實質上打平。OSWorld、Humanity's Last Exam、CursorBench 則是 Opus 5.5 領先 2 到 3 個百分點。
差距最明顯的是 FrontierCode 1.1:Sonnet 5.5 是 46.2%,Opus 5.5 是 54.4%,差 8.2 個百分點,Sonnet 5.5 甚至低於 GPT-6 Sol 的 49.3%。Anthropic 的說明也很直接:Opus 5.5 在需要持續判斷的複雜、開放式工作上仍然明顯較強。
另外,Sonnet 5 在 Terminal-Bench 4.0 只有 10.3%,跳到 70.6% 是很大的一步。這個跳幅有多少來自模型能力、多少來自評測版本或測試設定,目前的公開資料看不出來,引用時建議把 Sonnet 5.5 和 Opus 5.5 的比較放在前面,Sonnet 5 的比較放後面。
換模型前要先看的 API 改動
DataCamp 整理了幾項會影響既有整合的改動:
對照上一節,這幾項有一個共通結果:你的成本量測要在改完整合之後再做。自適應思考預設開啟,代表同一個 prompt 產生的 token 數可能和舊模型不同,這也正是官方說每任務成本會變的來源,量出來的數字會直接反映這一項。
安全機制方面,DataCamp 提到資安相關請求可能會退回 Sonnet 5 處理,推理內容的擷取被擋下,thinking block 綁定帳號。做資安工具的團隊,要確認自己的請求會不會被這條規則分流。
規格上,上下文視窗是 100 萬 token,單次輸出上限 12.8 萬 token(Batch API 加上 beta header 可到 30 萬)。知識截止日為 2026 年 6 月。Anthropic 承諾這個模型不會早於 2027 年 9 月 28 日退役,也提供零資料保留選項。Claude 網頁與 App、Claude Code、Claude API,以及 Amazon Bedrock、Google Cloud、Microsoft Foundry 都可以用。
哪些工作先換,哪些先留在 Opus 5.5
前面的基準分數給了一條粗略的分界線。Terminal-Bench 4.0 測的是在終端機裡完成任務,GDPval-AA 與 AA-Briefcase 測的是辦公室類的交付物,OSWorld 測的是操作桌面軟體。這幾項 Sonnet 5.5 都和 Opus 5.5 只差 0 到 2 個百分點,或在 Terminal-Bench 上領先。這類工作的共同點是結果可以被檢查:指令有沒有跑成功、檔案有沒有產出、表格數字對不對。
FrontierCode 1.1 與 Anthropic 那句「持續判斷」的說明,指向另一類工作:需求本身模糊、要自己決定拆成哪些步驟、中途要判斷方向對不對。這類任務失敗時,要付的是整個流程重跑的時間,或是一份看起來合理、方向卻錯的成果,多花的 token 費用反而是小項。
實際的分流可以這樣設:客服草稿、資料整理、程式碼審查、批次的文件轉換,走 Sonnet 5.5,並開 Batch API 拿五折;架構設計、需求不明的重構、需要長時間自主執行的代理流程,先留在 Opus 5.5,等自己的量測資料證明 Sonnet 5.5 也能做,再逐項移過去。
Batch API 的折扣和模型選擇可以疊加,兩者各自獨立。另外,官方公告與各家評測整理都沒有提到批次呼叫會降低品質,只是回應不是即時的。用 Sonnet 5.5 跑批次工作,輸入是 1 美元、輸出是 5 美元(每百萬 token),是同樣任務在 Sonnet 5.5 即時呼叫價格的一半。對不需要即時回應的整理型工作,這比單純換模型省得更確定,因為折扣是固定的價目,不取決於任務內容。
還有一項容易漏掉的成本:改整合的人力。上一節列的五項改動,每一項都要有人讀文件、改程式、跑測試。團隊只有一兩支程式在用 Sonnet 5 時,這筆成本很小;有幾十個內部工具各自呼叫模型時,遷移成本可能比省下的 token 費用還高,要先算過再排時程。
自己量成本:三個數字
官方數字與第三方實測不一致時,最可靠的依據是自己的流量。做法可以很小:
第一個數字是每任務的輸入與輸出 token。用同一批任務、同樣的 prompt 各跑一次,記下 API 回傳的 usage。Sonnet 5.5 的自適應思考預設開啟,思考用掉的 token 也在輸出裡,要一併計入。
第二個數字是任務完成率:一次就做對、不需要重跑的任務占幾成。Base44 的例子顯示,迭代次數少一半(3.6 對 7.7)可以比單價差異更能左右成本。任務要重跑幾次才能交付,比每次多花幾分錢更影響總額。
第三個數字是延遲。官方說輸出速度快 30% 以上;llm-stats 列出的 p95 首字時間是 0.40 秒。你的服務如果在意等待時間,這個數字要用自己的請求長度重測。
有快取的工作流程要另外算。快取讀取是 0.2 美元,只有輸入單價的十分之一。長 prompt 反覆使用的應用,成本大部分落在快取讀取與輸出,token 用量減少的幅度會和前面的實測不同。
還不確定的地方
第一,「每任務成本最多低 30%」是上限,官方沒有公布平均值,也沒有公布是在哪些任務上量到的。
第二,早期測試者的數字沒有統一的計算方式。Box 的 12% 是 token 減量,Atlassian 的 30% 是速度,Base44 是迭代次數,三者不能相加或互換。
第三,Sonnet 5 到 Sonnet 5.5 的基準跳幅很大,尤其是 Terminal-Bench 4.0 的 10.3% 對 70.6%,原因尚未有公開說明。
第四,DataCamp 的實測是單一任務、單次執行,只能說明這個任務的情況。