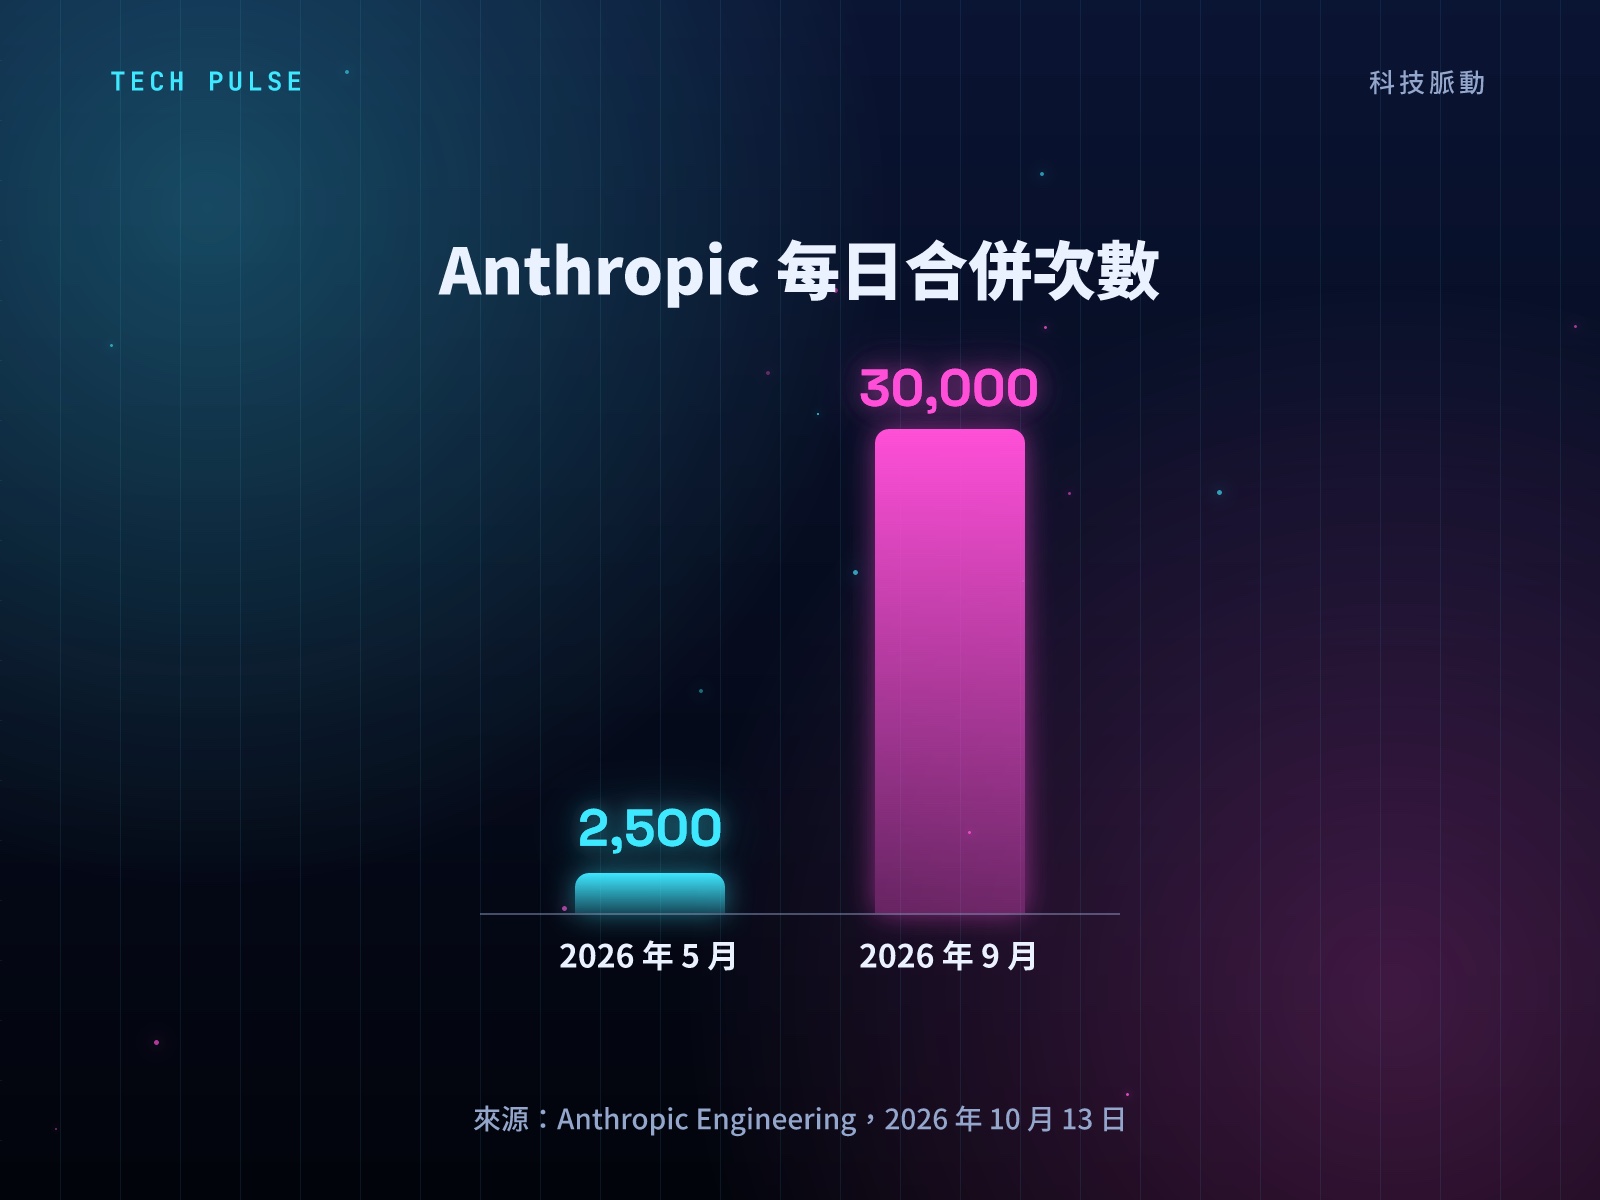
10 月 13 日,Anthropic 在工程部落格發表〈Redesigning source control at Anthropic〉,公布一套自製的版本控制系統 Scion。文章給了幾個數字:每日合併次數從 5 月的約 2,500 次,升到 9 月的逾 30,000 次;CI 每天約有 2,500 萬次 checkout;主分支歷史接近 100 GB,壓縮後的工作目錄超過 25 GB。
這篇文章最容易被讀成「Git 不夠用了,大家都該換」。作者自己的說法正好相反:Scion 不是 Git 的通用替代品,只適合數萬名工程師或大批代理同時工作的超大 monorepo,而且不開源、不當產品賣。多數團隊該帶走的是另一件事:代理開始大量跑 CI 之後,clone 與 checkout 會先變成瓶頸,Git 內建的 partial clone、sparse-checkout 與 scalar 現在就能先開。
數字從哪裡來
Anthropic 的說法是,Claude 產生程式碼的速度,已經超過人類尺度的基礎設施能吸收的量。The Register 的報導引用同一組數字,並提到 GitHub 把 4 月的可用性問題歸因於 pull request 與 commit 的指數成長,把它放進更大的趨勢裡看。
Anthropic 的數字有三組。每日合併從 5 月約 2,500 次到 9 月逾 30,000 次,成長超過十倍。CI 每天約 2,500 萬次 checkout,這還不含開發環境、代理沙箱與研究任務。如果每次都完整抓取,Git 流量會超過每天 600 PB。
這三個數字都是 Anthropic 自己的內部資料,沒有第三方查證。判斷這件事和你有沒有關係,要看的是比例而不是絕對值:你的 CI 每天 checkout 幾次、單次要抓多少資料。
Git 在這個規模卡在哪裡
Anthropic 對 Git 的批評集中在一個設計假設:Git 是分散式、離線優先的,每個客戶端都能持有完整歷史。這對多數程式庫是對的。Anthropic 的客戶端卻幾乎全是隨時在線的代理與任務,離線能力用不到,持有完整副本的成本卻照付。
他們原本靠一堆變通辦法撐住:shallow clone、sparse checkout、promisor remote,以及放在物件儲存裡的 repository seed。尖峰時還跑著數百個內部 Git 鏡像。合併速度提高後,鏡像的維運變得吃力,seed 在兩次更新之間也和主分支的最新狀態差得更遠。
這一段值得注意的是順序。Anthropic 先把 Git 提供的省流量功能用到極限,才走到自製。一般團隊的起點是前半段,也就是把這些內建功能開起來。
Scion 的設計
文章列出六項原則。客戶端永遠在線,需要什麼才抓什麼。伺服器負責歷史、blame、commit、merge 與 rebase。查詢都透過 API 暴露,很多任務根本不需要本機的 repository。系統可以水平擴充,連伺服器上也沒有完整副本,沒有 packfile,也沒有 repository 維護工作。commit 發生在伺服器端,所以沒有 push,成本跟變更的大小有關,跟 repository 的大小無關。工作目錄是選配的,稀疏、虛擬化,只在被讀到時才把檔案實體化。
資料模型上,工作單位是 changeset,也就是寫前日誌(write-ahead log)裡的一筆紀錄:記下相對於第一個父節點改了哪些檔案,並以內容定址的方式指向儲存裡壓縮過的 blob。Git 風格的歷史與 blame 是衍生資料,由父節點的值遞迴算出。ref 更新則是對 Spanner 單一資料列做 compare-and-swap。
架構分三層。每個節點上有 scion-daemon,存放該節點上各任務共用的物件;區域層有 scion-cache,把物件從記憶體串流出去;最上層是 scion-server,快取沒命中時從 Spanner 或雲端儲存讀取。三層回應同一組 RPC,層級之間嚴格隔離,避免某個區域快取故障時把上游伺服器壓垮。請求是遞迴且可續傳的,不會出現一個好幾 GB 的 packfile 回應。
效果與代價
Anthropic 公布的結果:CPU 與記憶體用量比原本的 Git 鏡像基礎設施小約 200 倍;CI 與研究任務的 checkout 快約兩個數量級,從分鐘降到秒;光是 CI 就多出 25% 的 CPU 容量;每一層快取的命中率都在 99% 以上。
做出這套系統的團隊是七個人,同時還做了程式碼審查工具 Antique 與其他約六個相關系統。整個遷移花了五個月,期間每日合併量大約成長十倍。The Register 補充,開發從 1 月開始,另外還有數個月以提示詞驅動的前期工作。
代價也寫得很清楚。Scion 偏離 Git,需要自己的審查、搜尋與 CI 工具,所以 Anthropic 判斷很難包裝成對外通用的產品。它的內部 token 花費也遠高於多數企業能負擔的水準,文章自己把這點列為背景。
另一個細節是工程師的角色。Anthropic 說,這個專案裡 Claude Mythos Preview 重寫了一個手工打造的 Git 到 Scion 匯入原型,記憶體用量少 20 倍、速度快 4 倍,同時保留了排序與資料結構的不變條件。但工程師「很常」要做的事是對 Claude 說不:例如該去問程式碼審查工具的地方,Claude 寫成暴力掃描 commit 紀錄;或是在對抗式審查之下加了過度防禦的驗證。
一般團隊先做什麼
如果你的 CI 每天只跑幾十到幾百次,這一節的設定就夠了,不需要任何新系統。三個工具都是 Git 官方文件裡的功能。
第一,partial clone。clone 或 fetch 時帶 `--filter`,伺服器在打包時就略過一部分物件,客戶端用到時才補抓。
```sh
略過所有 blob,需要時才抓
git clone --filter=blob:none https://example.com/repo.git
treeless:連 tree 也略過
git clone --filter=tree:0 https://example.com/repo.git ```
補抓的來源叫 promisor remote,通常就是 origin。限制有幾個:伺服器必須支援 pack protocol 的 filter 能力;補抓時必須連得上遠端;動態補抓是一次一個物件地呼叫 fetch-pack,次數多了會有額外開銷。它也只限制 blob 與 tree,不限制 commit,所以不能取代 shallow clone。
第二,sparse-checkout。只把你要的目錄展開到工作目錄。
```sh git sparse-checkout set services/api libs/common ```
第三,scalar。它是 Git 附帶的工具,用來管大型 repository:套用一組建議設定,並在背景跑維護。
```sh scalar clone https://example.com/repo.git scalar register scalar run config ```
`scalar clone` 預設只抓 commit 與 tree,並開啟 sparse-checkout,工作目錄放在 `<enlistment>/src` 底下,一開始只有最上層檔案。它也會設 `commitGraph.changedPaths=true` 加速檔案歷史查詢、開啟背景維護並關掉自動 gc、把 `fetch.unpackLimit` 設成 1,並關掉 `status.aheadBehind` 這類昂貴的計算。已經 clone 好的 repository 用 `scalar register` 納入管理。
這三個放在一起,正好對應 Anthropic 文章裡的「稀疏、虛擬化的工作目錄」和「客戶端不需要持有全部物件」,只是做法留在 Git 的框架內。Anthropic 自己也說,他們希望其他開發者能把 Scion 的部分想法套回 Git,並點名伺服器端 RPC、新的伺服器架構,以及可組合的 sparse 與 shallow 功能;GitHub、GitLab 與開源社群被列為可能的合作對象。
建議的做法是先量再改。挑一條最慢的 CI 工作,記下 checkout 花的秒數和傳輸量;改成 partial clone 加 sparse-checkout;再量一次。如果差距大,再全面推。這個流程不需要改變任何人的日常工作方式,出問題時也能一行設定改回原狀。另外要留意,CI 用的 runner 如果每次都是全新環境,沒有任何快取,partial clone 帶來的省流量最明顯;如果 runner 本來就常駐並保留 repository,效益會小一些,先量才不會白忙。
還不確定的地方
目前沒有第三方驗證 200 倍、兩個數量級或 99% 命中率這幾個數字,這些都是同一家公司對自家系統的描述。Scion 也不會開源,文章只說明設計思路。
另一個沒有答案的問題是,合併速度再往上走,哪些環節會是下一個瓶頸。Anthropic 的做法是放棄全域合併佇列的鎖,改靠合併後與部署前的自動化測試,接受並行的變更可能互相衝突,並說 Claude 通常修衝突比人發現得更快。這個取捨在別的組織是否成立,文章沒有證據,也不是每個團隊都承擔得起。
最後,partial clone 與 scalar 的實際效益取決於你的伺服器、repository 結構與 CI 設定。官方文件沒有提供具體倍數,要用自己的數字說話。